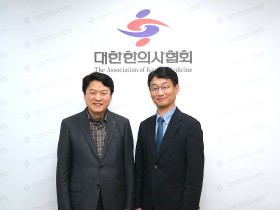
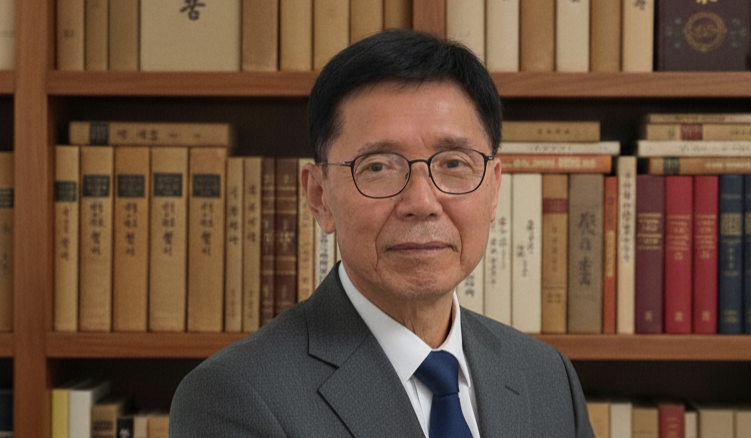
[한의신문=주혜지 기자] 가천대학교 한의과대학 김창업 교수(사진) 연구팀이 최근 생성형 인공지능 모델(generative AI model)인 GPT-4가 한의학 데이터에 대한 특별한 훈련 없이 한의사 국가시험을 통과하는 성능을 나타냈다고 밝혔다. 기존 연구에서는 GPT-4가 한의사 국가시험을 간발의 차로 합격하지 못했던 반면 이번 연구에서는 언어모델에게 문항을 제시하는 방식을 최적화하여 모델의 성능을 극대화하는 기법인 프롬프트 엔지니어링(prompt engineering)을 활용해 합격 수준을 달성했다.
연구팀은 2022년 한의사 국가시험에 포함된 340문항을 GPT-4에 제시한 뒤 GPT-4의 정답률을 평가했다. 그 결과 GPT-4는 전체 문항 중 66.18%의 문항에 대해 정답을 맞혔으며, 각 과목에 대해서도 과목별 과락 기준인 40%보다 높은 정답률을 나타냈다. 구체적으로는 △본초학 87.5% △소아과학 81.2% △부인과학 79.2% 과목에서 높은 정답률을 나타냈으며, 한국의 특성을 반영하는 상한론‧사상의학(43.8%)이나 보건의약관계법규(40.0%) 과목에서는 상대적으로 낮은 정답률을 보였다.
특히 이번 연구에서는 프롬프트 엔지니어링에 따라 GPT-4의 성능이 합격·불합격에 영향을 미칠 만큼 성능에 큰 영향을 주는 것도 확인했다. 한국어로 된 문항을 그대로 입력했을 경우에는 평균 정답률이 51.82%였던 것에 반해, 한의학 용어를 한자로 병기했을 때는 57.59%, 지시와 문제를 영어로 스스로 번역해 풀게 했을 경우에는 63.65%로 증가했다. 또한 같은 문항에 대해 반복적으로 답변을 얻은 뒤 답변 중 가장 빈도가 높게 등장한 답을 최종 답으로 선택하는 자기일관성(Self-consistency) 기법을 사용했을 경우 정답률이 66.18%로 향상되는 현상을 확인했다.
이와 관련 김창업 교수는 “기존 연구에 비해 이번 연구에서는 프롬프트 엔지니어링을 통해 한의학적 문제해결능력을 강화할 수 있다는 사실을 밝혔다는데 의의가 있다”며 “동일한 내용의 문제라도 어떤 언어로 사고하는지, 어떤 방식으로 사고하는지에 따라 큰 성능의 차이가 있었다는 데에 주목할 필요가 있다”라고 밝혔다.
이번 연구를 함께 수행한 장동엽 연구원은 “한국의 특수성을 반영하는 보건의약관계법규, 상한론‧사상의학과 같은 과목들에서 낮은 점수가 나왔다는 것에 주목할 필요가 있다”며 “이는 GPT-4와 같은 글로벌 기업에서 구축된 AI가 한국의 특수성을 잘 반영하지 못할 수 있다는 점을 보여주며, 추후 의료 인공지능 개발시 각 지역의 특수성을 반영할 수 있는 노력이 필요하다는 점을 보여준다”고 말했다.
한편 이번 연구 결과는 ‘PLOS Digital Health’ 저널에 “GPT-4 can pass the Korean National Licensing Examination for Korean Medicine Doctors”라는 제목의 논문으로 출판됐다(DOI: 10.1371/journal.pdig.0000416).
 속초1.1℃
 백령도2.6℃
 울릉도2.3℃
 전주1.2℃
 목포4.1℃