• 맑음속초1.8℃
  • 맑음1.2℃
  • 맑음철원-0.1℃
  • 맑음동두천2.9℃
  • 맑음파주1.6℃
  • 맑음대관령-4.2℃
  • 맑음춘천2.3℃
  • 흐림백령도2.8℃
  • 맑음북강릉3.2℃
  • 맑음강릉3.3℃
  • 맑음동해4.0℃
  • 맑음서울1.4℃
  • 맑음인천1.8℃
  • 맑음원주1.6℃
  • 흐림울릉도2.3℃
  • 맑음수원2.2℃
  • 맑음영월1.0℃
  • 구름많음충주1.8℃
  • 흐림서산1.5℃
  • 맑음울진5.3℃
  • 구름많음청주2.3℃
  • 눈대전1.2℃
  • 구름많음추풍령-0.3℃
  • 맑음안동3.2℃
  • 구름많음상주2.1℃
  • 맑음포항4.9℃
  • 흐림군산1.0℃
  • 구름많음대구4.0℃
  • 눈전주0.7℃
  • 맑음울산5.7℃
  • 맑음창원6.4℃
  • 구름많음광주5.2℃
  • 맑음부산8.4℃
  • 맑음통영8.3℃
  • 비목포4.1℃
  • 맑음여수6.0℃
  • 구름많음흑산도6.8℃
  • 흐림완도6.2℃
  • 흐림고창3.1℃
  • 구름많음순천3.3℃
  • 눈홍성(예)0.4℃
  • 구름많음1.7℃
  • 구름많음제주10.7℃
  • 구름많음고산10.7℃
  • 구름많음성산8.7℃
  • 맑음서귀포11.6℃
  • 맑음진주7.5℃
  • 맑음강화2.0℃
  • 맑음양평2.7℃
  • 구름많음이천3.1℃
  • 맑음인제0.3℃
  • 맑음홍천1.5℃
  • 맑음태백-1.9℃
  • 맑음정선군0.5℃
  • 맑음제천0.6℃
  • 흐림보은1.1℃
  • 구름많음천안2.5℃
  • 흐림보령1.1℃
  • 흐림부여2.3℃
  • 흐림금산1.9℃
  • 구름많음1.0℃
  • 흐림부안0.9℃
  • 구름많음임실1.4℃
  • 흐림정읍2.2℃
  • 구름많음남원3.1℃
  • 흐림장수0.5℃
  • 흐림고창군2.4℃
  • 흐림영광군4.0℃
  • 맑음김해시7.1℃
  • 구름많음순창군2.9℃
  • 구름많음북창원6.3℃
  • 맑음양산시6.7℃
  • 맑음보성군6.5℃
  • 흐림강진군5.6℃
  • 구름많음장흥5.4℃
  • 흐림해남4.3℃
  • 구름많음고흥6.2℃
  • 맑음의령군7.0℃
  • 구름많음함양군4.4℃
  • 맑음광양시7.1℃
  • 구름많음진도군7.0℃
  • 맑음봉화1.1℃
  • 맑음영주1.9℃
  • 구름많음문경2.1℃
  • 맑음청송군2.6℃
  • 맑음영덕4.7℃
  • 맑음의성4.1℃
  • 구름많음구미4.4℃
  • 맑음영천4.0℃
  • 맑음경주시5.0℃
  • 구름많음거창3.2℃
  • 구름많음합천6.1℃
  • 구름많음밀양5.7℃
  • 구름많음산청4.4℃
  • 맑음거제7.0℃
  • 맑음남해7.1℃
  • 맑음7.0℃
기상청 제공

2026년 11월 20일 (금)

“인공지능 GPT-4, 한의사 국시서 합격선 근접”

“인공지능 GPT-4, 한의사 국시서 합격선 근접”

임상현장서 데이터 수집, 인공지능 개발 등 발전 가능성 ‘확인’
김창업 가천대 한의대 교수 연구팀, ‘arXiv’에 연구 결과 게재

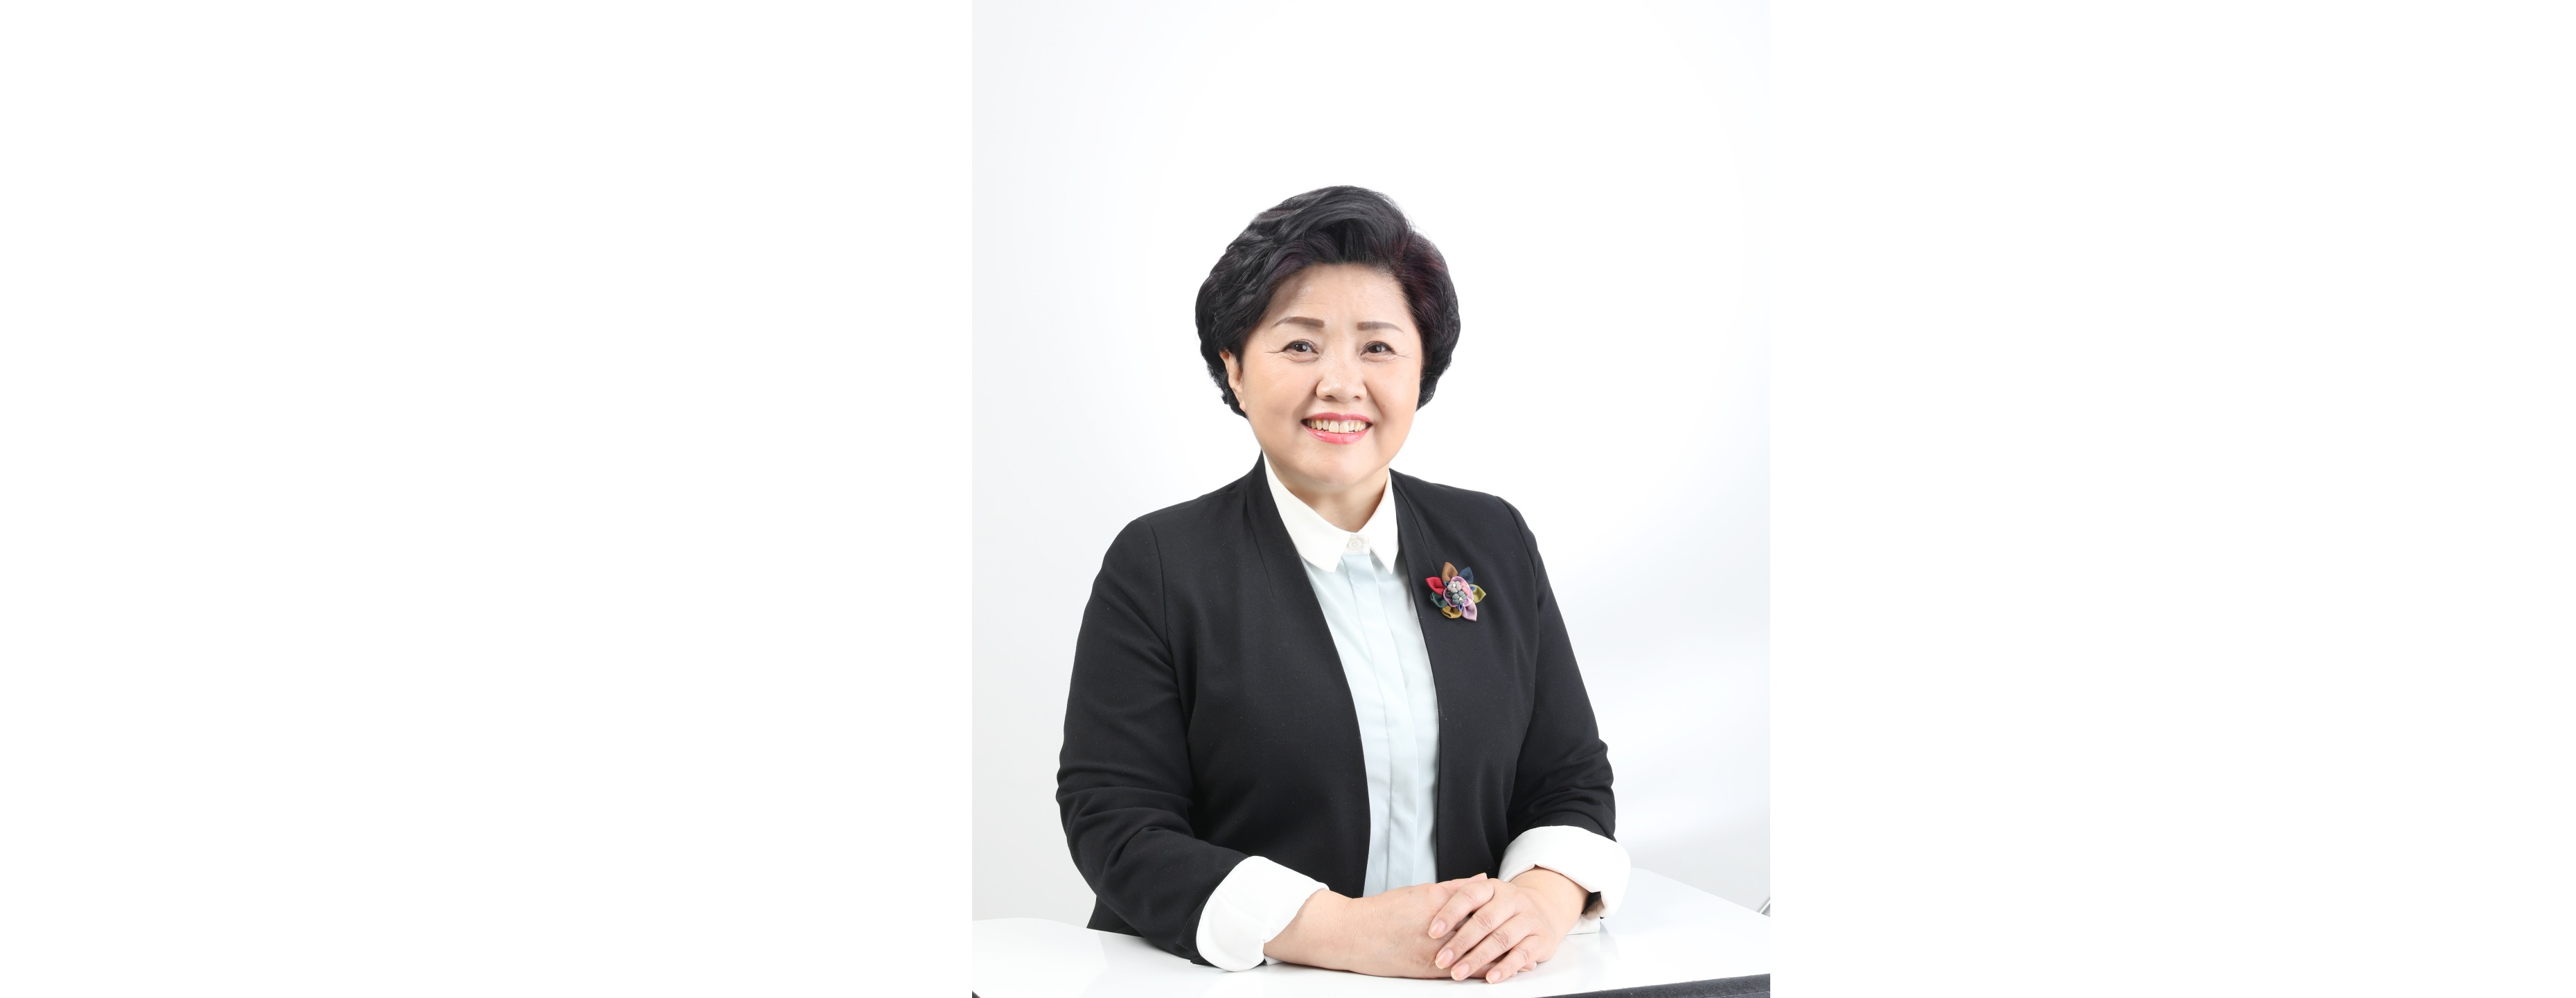
김창업.jpg
김창업 가천대학교 한의과대학 교수


김창업 가천대학교 한의과대학 교수 연구팀은 생성형 인공지능 모델(Generative AI model)인 GPT-4가 한의사 국가시험에서 합격선에 근접한 성적을 거뒀다고 밝혔다.


GPT-4는 ChatGPT를 개발한 OpenAI에서 지난달 14일 공개한 생성형 거대언어모델(Generative large language model)로, ChatGPT보다 우수한 성능으로 변호사 시험, 생물 올림피아드 등 각종 시험에서 사람을 능가하는 퍼포먼스를 보여줘 큰 주목을 받은 바 있다. 뿐만 아니라 미국 의사시험에서 이미 높은 성적을 기록, 의료 인공지능 개발에 이러한 언어 모델을 활용할 수 있을 것인지에 대한 논의가 활발히 이뤄지고 있다.


이에 김창업 교수 연구팀은 이 모델을 한의학 인공지능 개발에도 적용할 수 있을지를 평가하고자 연구를 진행했다. GPT-4는 2022년 시행된 한의사 국가시험에서 평균 57.29%의 정답률을 기록했으며, 이는 합격선인 60%에 근접하는 성적이다. 이러한 결과가 한의학 혹은 의학 분야에 대한 별도의 추가 훈련 없는 사전학습 모델만으로 이뤄졌다는 점에서 주목할 만한 성과라고 할 수 있다는 평가다. 


특히 이번 연구에서는 한국 의료에 인공지능을 적용할 때 발생할 수 있는 문제점 역시 발견했다는 의의가 있다는 설명이다.

gpt4.PNG

즉 GPT-4는 과목별로 정답률의 차이가 크게 나타났다. 이 중 국제적으로 표준화된 진단기준에 대한 문제가 주로 출제된 신경정신과학에 대해서는 높은 성능을 나타낸 반면 서양의학뿐 아니라 중의학과도 차별화되는 이론을 다루는 내과학2 과목에서는 가장 낮은 정답률을 나타냈다. 특히 한국의 의료법을 다루는 과목은 한의학과 직접적인 연관이 없음에도 낮은 정답률을 나타냈다.


이에 대해 연구팀은 “영미권에서 생산된 데이터로 학습된 GPT-4는 전 세계에서 통용되는 지식에 대해서는 충분히 학습했지만, 한국에서만 적용되는 의료법이나 보험체계, 한국에서 권장되는 임상지침 등에서는 충분히 학습하지 못했을 수 있다”고 설명했다.


장동엽.png
장동엽 연구원


또한 이번 연구를 주도한 김창업 교수와 장동엽 연구원은 “이번 연구를 통해 대중화되고 있는 거대언어모델을 활용한 한의임상현장에서의 자동화된 데이터 수집, 한의임상보조 인공지능, 한의대생이나 한의사의 진료 기술을 훈련할 수 있는 학습용 인공지능 개발 등 다양한 발전 가능성을 확인했다”며 “한의학에 대한 AI 개발뿐 아니라 각 국가의 상황에 맞는 의료 인공지능 개발에 참고할 수 있는 기초 자료로 활용되길 희망한다”고 밝혔다.


한편 이번 연구는 지난달 31일 ‘아카이브(arXiv)’에 “Exploring the Potential of Large Language models in Traditional Korean Medicine: A Foundation Model Approach to Culturally-Adapted Healthcare(doi: https://doi.org/10.48550/arXiv.2303.17807)”라는 제하의 논문으로 공개됐다.


관련기사

가장 많이 본 뉴스

더보기
  • 오늘 인기기사
  • 주간 인기기사

최신뉴스

더보기

뉴스

더보기